Más allá de Claude: Buscando el orquestador ideal para agentes de IA
El ecosistema de la programación agéntica está evolucionando a una velocidad sin precedentes. Aunque stacks como OpenCode y OhMyOpenagent ofrecen capacidades increíbles, la volatilidad en los precios de los tokens y la inestabilidad corporativa en proveedores clave nos obligan a buscar alternativas sólidas y verificables para el rol de orquestador principal.
Comparativa de rendimiento: Grok, Minimax y Laguna frente a los gigantes AAA.Tras analizar diversas opciones a través de OpenRouter, evaluando factores críticos como la duración de la orquestación, el valor por token y la eficacia de integración, los hallazgos son contundentes. No todos los modelos con alta capacidad de razonamiento son buenos orquestadores; muchos caen en bucles infinitos o fallan al ejecutar herramientas críticas en entornos reales.
Los tres ganadores del experimento
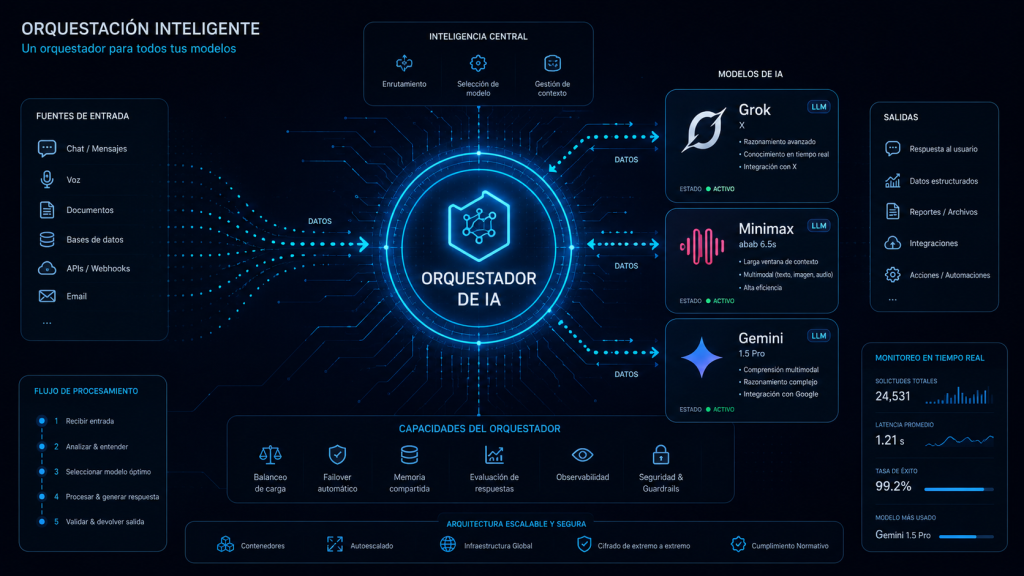
- Grok-4.20-beta: Se posiciona como el sustituto más fuerte. Destaca por su seguimiento preciso de subtareas y una integración excepcional con herramientas y hooks.
- Minimax-m2.7: La gran sorpresa del mercado. Un modelo consistente, con ratios de tokens excelentes y una convergencia confiable en tareas de larga duración.
- Laguna-m.1 (Poolside): El «mejor valor» descubierto. Siendo gratuito, superó todas las expectativas en eficacia de integración, aunque presenta limitaciones en diseño de sistemas complejos.
Categorías analizadas
El análisis dividió los modelos en cuatro grandes grupos: los «AAA» (Google y OpenAI), potentes pero a veces lentos o costosos; los «Runner-Ups» donde brilla Grok; las «Ovejas Negras» como Minimax; y los modelos de «Peso Abierto» como Gemma o Nemotron, que por ahora no alcanzan el nivel para orquestación pesada sin ajustes finos.
Opinión Corporativa: La eficiencia no se compra, se arquitecta
Desde nuestra experiencia en la implementación de sistemas de automatización complejos, la dependencia de APIs de «caja negra» sin capas de abstracción claras representa un riesgo operativo crítico. En flujos productivos, hemos detectado repetidamente que la supuesta «inteligencia propietaria» de muchas herramientas comerciales desaparece al analizar el tráfico de red, revelando llamadas directas a proveedores de inferencia de bajo coste o modelos de código abierto enmascarados.
En implementaciones reales, hemos desplazado el enfoque hacia la soberanía del pipeline. Priorizamos el uso de orquestadores locales o el empleo de herramientas como n8n para mantener el control total sobre la lógica de decisión y la gestión de tokens. La eficiencia no reside en el modelo más caro o con la mayor cantidad de parámetros, sino en la arquitectura que mejor gestione el contexto y delegue tareas sin caer en bucles circulares. Si el orquestador no converge rápidamente en la solución técnica, el coste por token se vuelve irrelevante frente a la ineficiencia operativa. La transparencia en la inferencia no es una opción de marketing, es un requisito de seguridad para la integridad de los datos corporativos.
Conclusión
La orquestación de agentes IA ha dejado de ser un problema de capacidad de razonamiento bruto para convertirse en un desafío de eficacia de integración y gestión de latencia. La estrategia ganadora para el mercado actual no es la adopción acrítica del modelo «AAA» más publicitado, sino la implementación de una arquitectura híbrida de roles divididos (split-role strategy): un orquestador robusto para la toma de decisiones de alto nivel, apoyado por modelos ligeros y locales para la ejecución de tareas específicas.
Para garantizar la escalabilidad y la seguridad, es imperativo validar técnicamente cada eslabón de la cadena de inferencia mediante auditorías de red y pruebas de estrés en entornos de producción. La verdadera ventaja competitiva no la tiene quien posee el modelo más grande, sino quien logra la orquestación más fluida y auditable.
Referencias Formales
- Tythos. (2026). «Some Notes on OMO Orchestrator Claude Alternatives». Análisis comparativo de rendimiento en stacks agénticos.
- Harsh. (2026). «DeepSeek Is Running Inside Your Favorite AI Tool». Informe sobre transparencia en infraestructura de inferencia.
- OpenRouter Benchmarks. (2026). Datos de rendimiento en tiempo real para modelos Grok-4.20-beta, Minimax-m2.7 y Laguna-m.1.